
OCR и интеллектуальная обработка финансовых документов
Распознавание паспортов, договоров, выписок и первичных документов с извлечением полей, проверкой и передачей в учётные системы.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Банк, страховщик или лизинговая компания ежедневно принимает тысячи документов: паспорта и уставные документы для KYC, справки о доходах, договоры, счета, банковские выписки, акты. Операционисты вручную переносят данные в системы, ошибаются, а очередь на проверку тормозит выдачу продуктов.
Документы приходят в любом виде: сканы, фото с телефона под углом, многостраничные PDF с таблицами, рукописные заявления. Классическое OCR на таких входах даёт много ошибок и не понимает структуру.
Облачные сервисы распознавания недопустимы для документов с персональными данными и банковской тайной.
Что делает ИИ
PaddleOCRLayoutLM / DonutvLLMDoclingOpenCVPostgreSQL
Решение — конвейер интеллектуальной обработки документов на локальных моделях: от классификации входящего файла до структурированных данных в учётной системе.
- Классификация типа документа и разбиение многостраничных пакетов.
- Распознавание печатного и рукописного текста, таблиц, печатей и подписей с коррекцией геометрии фото.
- Извлечение полей и их нормализация языковой моделью: ФИО, реквизиты, суммы, даты, условия договора.
- Проверки: полнота пакета, соответствие полей между документами, признаки подделки; очередь ручной верификации только для сомнительных полей.
Конвейер интегрируется с СЭД, АБС и CRM через API; модели дообучаются на исправлениях операционистов и новых типах документов. Запуск начинается с 3–5 самых массовых типов документов, остальные добавляются по мере накопления примеров.
Какие данные нужны
- Архив документов с проверенными данными
- Шаблоны и справочники реквизитов
- Правила проверки пакетов по продуктам
Какая инфраструктура нужна
Профиль «компьютерное зрение и документы»: OCR-модели и модели понимания структуры работают на GPU с 24–48 ГБ памяти, а языковая модель для извлечения полей — на GPU с 48–96 ГБ. Для потока в десятки тысяч страниц в день достаточно рабочей станции W9 MAX из рабочие станции с двумя GPU и быстрым NVMe под очередь документов.
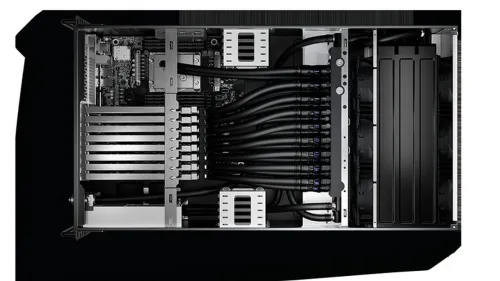
Если документооборот распределён по филиалам и нужен централизованный сервис с резервированием, подойдёт сервер R5 PLUS или RX PRO из раздела GPU-серверы. Документы обрабатываются в контуре организации, что соответствует требованиям к персональным данным и банковской тайне.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Финансы и страхование»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.