
Кредитный скоринг на машинном обучении для банков и МФО
Скоринговые модели на собственных и внешних данных с объяснимыми решениями, быстрым переобучением и контролем дрейфа.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Скоринговая карта, построенная несколько лет назад, стареет: меняются заёмщики, каналы привлечения, макроэкономика. Пересборка модели силами внешнего вендора занимает месяцы, и всё это время банк либо теряет хороших клиентов из-за жёстких отсечек, либо наращивает просрочку.
Данных стало больше — транзакции, поведение в приложении, данные бюро, внешние источники, — но классическая логистическая регрессия использует малую их часть. При этом регулятор и внутренний риск-комитет требуют объяснимости каждого решения, что ограничивает применение «чёрных ящиков».
Аналитики риска работают на ноутбуках или перегруженном общем сервере, и один эксперимент с полной выборкой занимает часы.
Что делает ИИ
PythonLightGBM / CatBoostSHAPMLflowFeastPostgreSQL
Мы выстраиваем контур моделирования кредитного риска на собственном вычислительном узле банка: от подготовки признаков до мониторинга моделей в промышленной эксплуатации.
- Модели градиентного бустинга на сотнях и тысячах признаков с встроенной объяснимостью (значения Шепли, коды причин отказа).
- Автоматическая генерация признаков из транзакций и поведенческих данных; нейросетевые эмбеддинги последовательностей операций как дополнительные признаки.
- Валидация по требованиям регулятора: стабильность, дискриминирующая способность, калибровка, тесты на группах.
- Мониторинг дрейфа данных и качества, переобучение по расписанию, версионирование моделей.
Скоринг заявок в реальном времени выполняется через API с задержкой в десятки миллисекунд, а полный цикл переобучения занимает дни, а не месяцы.
Какие данные нужны
- Кредитные заявки и история платежей
- Транзакции и поведение в приложении
- Данные бюро кредитных историй и внешних источников
Какая инфраструктура нужна
Профиль «большие данные и табличный ML»: обучение бустинга на выборках в десятки миллионов строк и тысячи признаков упирается в оперативную память и число ядер CPU; GPU ускоряет обучение в разы и нужна для эмбеддингов транзакционных последовательностей. Для команды риск-аналитиков достаточно рабочей станции W7 ULTRA из рабочие станции с 256–512 ГБ памяти и одной-двумя GPU.
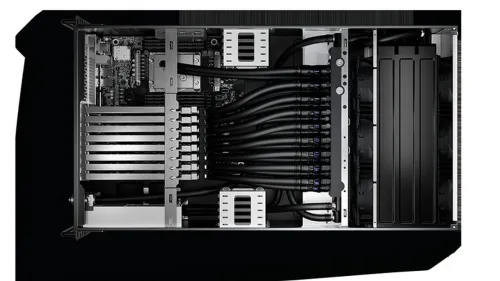
Для промышленного скоринга с высокой нагрузкой и регулярным переобучением на всей истории подходит сервер R7 PRO или RX PLUS из раздела GPU-серверы с NVMe-массивом под витрины признаков. Персональные данные заёмщиков не покидают контур банка, что упрощает соответствие требованиям к их защите.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Финансы и страхование»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.