GPU-серверы и рабочие станции для задач ИИ и HPC: подбор под нагрузку, а не под прайс-лист.
Инференс языковых моделей, обучение нейросетей, машинное зрение, инженерные симуляции, рендеринг. Разные задачи по-разному нагружают GPU, CPU, память и накопители, поэтому конфигурацию мы собираем от нагрузки. В портфеле три линейки: рабочие станции W-серии на 1–4 GPU, стоечные GPU-серверы R-серии на 1–16 GPU и платформа LM TEK 4U8GPU10KW с жидкостным охлаждением на 8 GPU.
Выберите задачу, и мы покажем, как под неё выглядит железо.
На каждой странице: что важно для этой нагрузки, примерные конфигурации из наших серий, аргументы за жидкостное охлаждение там, где оно оправдано, и короткий список того, что прислать для коммерческого предложения.
Сервер для инференса LLM
Чат-ассистенты, RAG по внутренним документам, агентные сценарии. Память GPU под модель и параллельных пользователей.
Подробнее →Сервер для обучения нейросетей
Дообучение открытых моделей, LoRA, обучение своих сетей. Постоянная нагрузка на все GPU часами и сутками.
Подробнее →Машинное зрение и видеоаналитика
Десятки потоков видео, детекция и сегментация в реальном времени, пропускная способность как главная метрика.
Подробнее →HPC и инженерные симуляции
CFD, прочностные расчёты, молекулярная динамика. Много ядер CPU, многоканальная ECC-память и GPU-солверы.
Подробнее →Медицинская визуализация и биоинформатика
Обработка КТ и МРТ, геномные конвейеры, обучение на данных учреждения, которые не покидают его периметр.
Подробнее →Контроль качества и предиктивное обслуживание
Визуальный контроль на линии, аналитика телеметрии оборудования, вычисления на площадке предприятия.
Подробнее →Рендеринг, генеративный дизайн, цифровые двойники
GPU-рендеринг, CAD/CAM, симуляция производств. От рабочей станции с несколькими GPU до рендер-узла на восемь карт.
Подробнее →Компактные и edge-развёртывания
Рабочие станции с несколькими GPU и одиночный узел 4U там, где нет дата-центра: лаборатория, филиал, цех.
Подробнее →Как мы подбираем конфигурацию.
- 01
Паттерн нагрузки
Чат и RAG, агентные сценарии, дообучение, классификация и извлечение, численное моделирование, рендеринг. Паттерн определяет, что станет узким местом: память GPU, число ускорителей, ядра CPU, накопители или сеть.
- 02
Масштаб и рост
Сколько пользователей, потоков или задач сейчас и через год. Рабочая станция W-серии, один узел R-серии или платформа, которая растёт от двух до восьми GPU в том же шасси: стартовая покупка не должна становиться тупиком.
- 03
Площадка
Стол, шкаф или стойка, доступная мощность, температура в помещении. Полностью укомплектованный узел на восемь GPU отдаёт в помещение до 7 кВт тепла, и это нужно заложить в охлаждение до поставки, а не после.
- 04
Спецификация и КП
Фиксируем BOM: GPU, CPU, память, NVMe, сеть, корпус и тип охлаждения. Для платформы LM TEK конфигурация внутри опубликованных валидационных спецификаций котируется как есть, за их пределами — через инженерную проверку вендора.
Рабочие станции, стоечные серверы и платформа с жидкостным охлаждением.
Рабочие станции W5 / W7 / W9 / WX
От одной RTX 5070 Ti на десктопной платформе до четырёх RTX PRO 6000 Blackwell на Threadripper PRO или двух EPYC. Для рабочего места инженера, художника, исследователя и для первого ИИ-узла без серверной.
Рабочие станции →GPU-серверы R5 / R7 / RX
Стоечные узлы от одной до шестнадцати GPU в 4U–10U: RTX 5090, RTX PRO 6000 Blackwell, H200 NVL, L40S. Плюс Supermicro B300 на HGX B300 NVL8 и ASUS ESC8000A-E13P на восемь ускорителей.
GPU-серверы →LM TEK 4U8GPU10KW
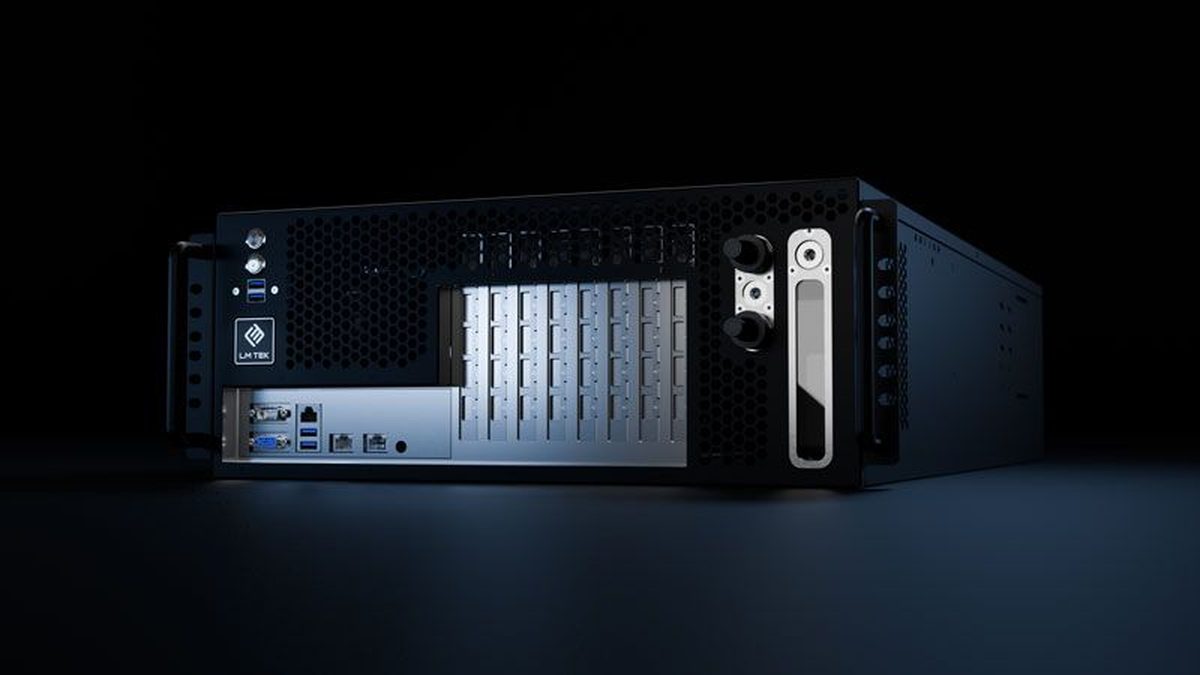
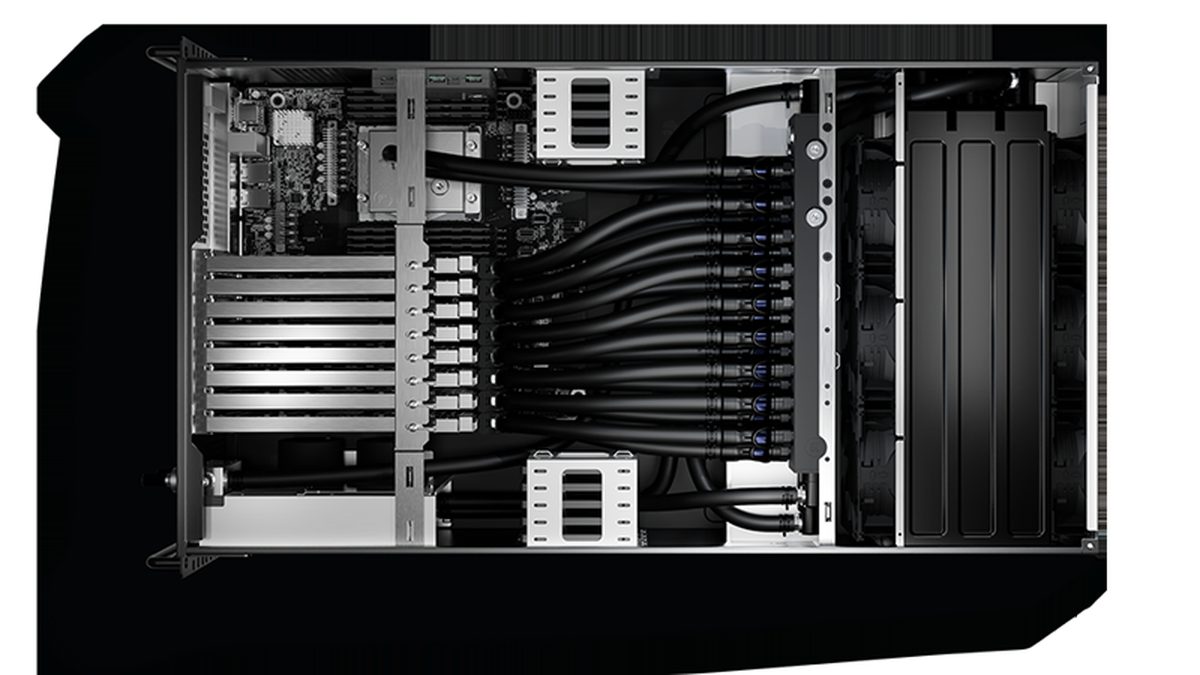
Платформа вендора LM TEK: восемь GPU до 700 Вт в 4U с замкнутым контуром жидкостного охлаждения внутри шасси, без внешнего CDU. Там, где стойка одна, а плотность нужна дата-центровая.
Платформа подробно →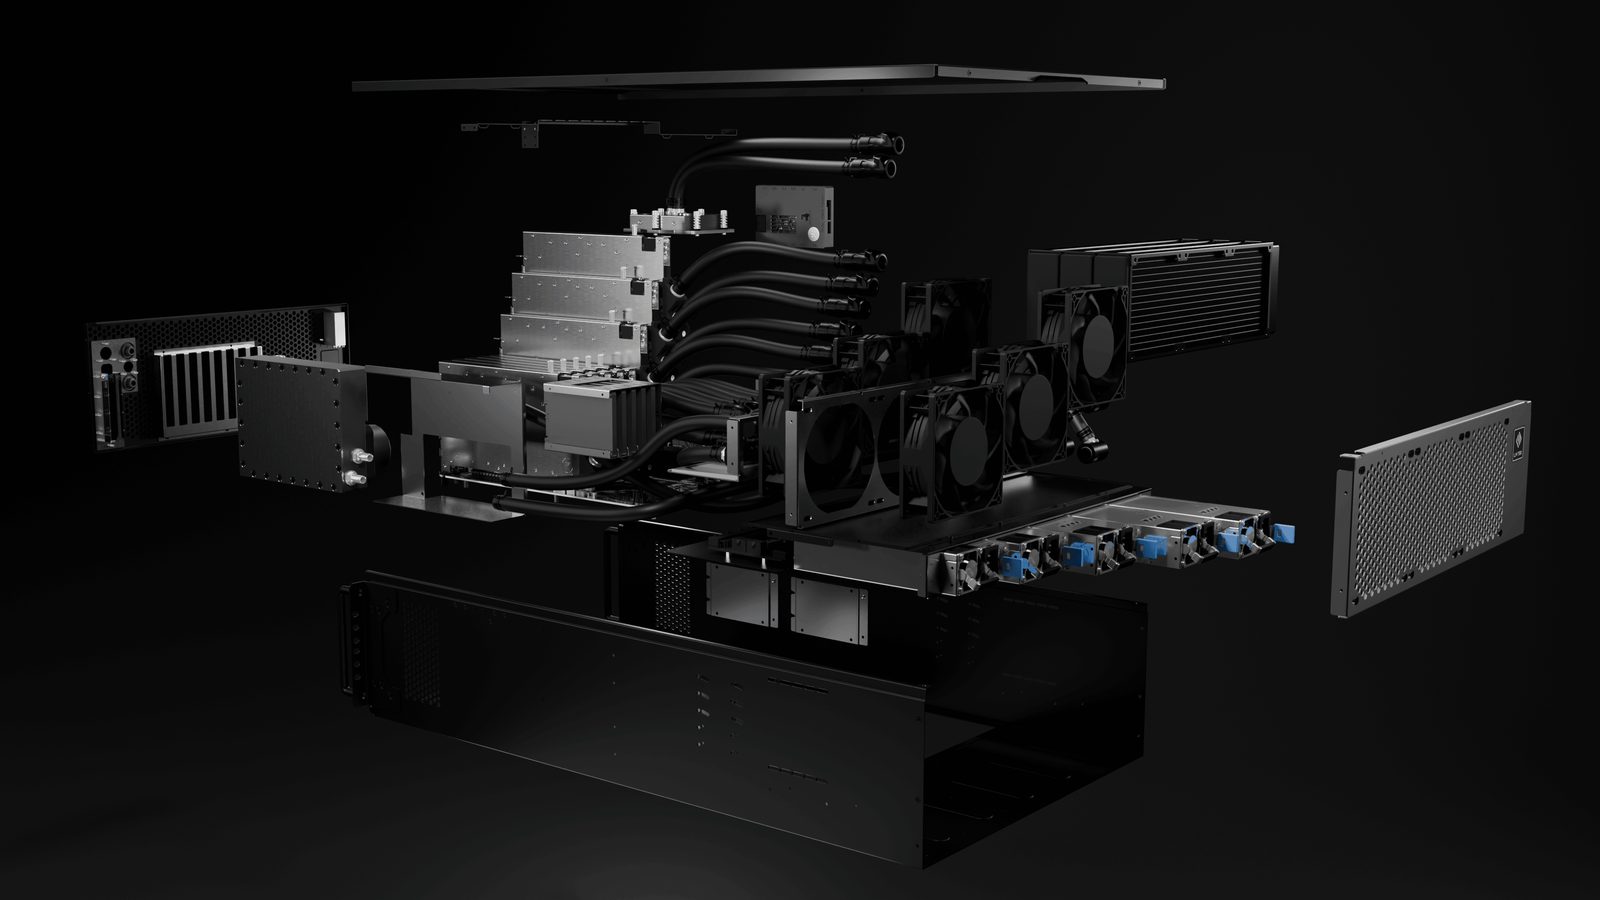
LM TEK 4U8GPU10KW
Barebone-платформа на восемь GPU до 700 Вт в шасси 4U с замкнутым контуром жидкостного охлаждения и радиатором внутри. Работает в стандартной серверной без сантехники здания и внешнего CDU. Плату, CPU, GPU, память и накопители подбираем под каждое внедрение.
- Количество GPU
- до 8 (конфигурации от 2 до 8)
- Мощность на слот GPU
- До 700 Вт на слот, длительно
- Поддерживаемые сокеты CPU
- AMD SP5, Intel LGA 4677, Intel LGA 4710, Intel LGA 4710-2 (в зависимости от выбранной платы)
- Блоки питания
- 5 × 2000 Вт CRPS, 80 PLUS Titanium, с резервированием