
GPU-сервер для инференса LLM в собственной серверной.
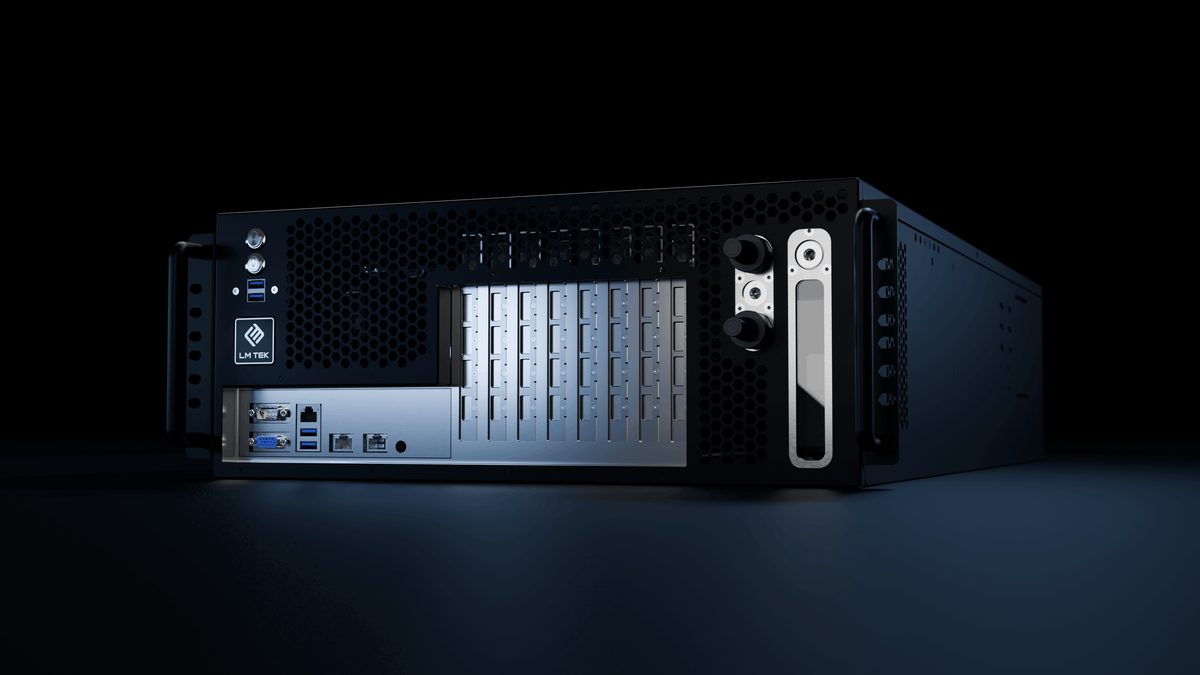
Запуск открытых языковых моделей внутри периметра организации: внутренние ассистенты, RAG по корпоративным документам, агентные сценарии с вызовом инструментов. GPU-сервер для инференса LLM собираем под сценарий: от одного узла R7 ULTRA с H200 NVL до RX ULTRA на шестнадцать H200 NVL и платформы LM TEK 4U8GPU10KW с жидкостным охлаждением, которая ставит восемь ускорителей в 4U и работает в обычной серверной без CDU.
Инференс LLM: память под модель и токены в секунду на пользователя.
У сервера инференса два ограничителя. Первый — суммарная память GPU: в неё должны поместиться веса модели и контекст всех одновременных сессий. Второй — скорость генерации на одного пользователя при заданной конкурентности. Медленный чат — мёртвый чат, поэтому нагрузку задаёт число одновременных пользователей, а не средняя за день.
Что это значит для железа. Класс модели выбирает объём памяти на карту, конкурентность — число карт. Меньшая, хорошо подобранная модель часто обслуживает больше людей, чем одна избыточно большая. Если поверх стоит RAG, добавляются три нагрузки: эмбеддинг-модель, векторная база и сам LLM, и тогда важны NVMe и CPU не меньше, чем GPU.
Отсюда три пути. Один узел 4U с одной H200 NVL для пилота. Восемь или шестнадцать H200 NVL в одном сервере для корпоративного сервиса. Или платформа LM TEK с жидкостным охлаждением, где старт с двух GPU и добавление карт по мере роста нагрузки происходят в том же шасси.
Три уровня сервера для запуска языковых моделей.
| Уровень | Серия · пример конфигурации | Для чего |
|---|---|---|
| Пилот одной команды | R7 ULTRA · 1 × NVIDIA H200 NVL · Threadripper 7970X · 256 ГБ ECC · 4U | Квантованная открытая модель, один сценарий, ограниченный круг пользователей, проверка «работает ли внутри периметра» |
| Корпоративный инференс | ASUS ESC8000A-E13P · 8 × NVIDIA H200 NVL · 2 × AMD EPYC 9965 · 3 ТБ ECC · 4U | Крупные модели, чат плюс RAG, несколько сценариев на одном узле, инференс как сервис для организации |
| Максимум конкурентности | RX ULTRA · 16 × NVIDIA H200 NVL · 2 × Xeon 8592+ · 8 ТБ ECC · 10U | Самые крупные открытые модели, сотни одновременных сессий, несколько моделей на одном сервере |
| Плотность с СЖО | LM TEK 4U8GPU10KW · от 2 до 8 GPU с водоблоками, например 8 × H200 NVL · 2 × Xeon Platinum 8580 · 1 ТБ ECC · 4U | Восемь GPU в 4U без CDU, рост от двух карт до восьми в том же шасси |
Конфигурации — примеры, не фиксированная спецификация; все позиции собираются под заказ. Итоговый BOM задаётся под внедрение. Ожидаемая скорость генерации для конкретной модели и числа пользователей уточняется при запросе.
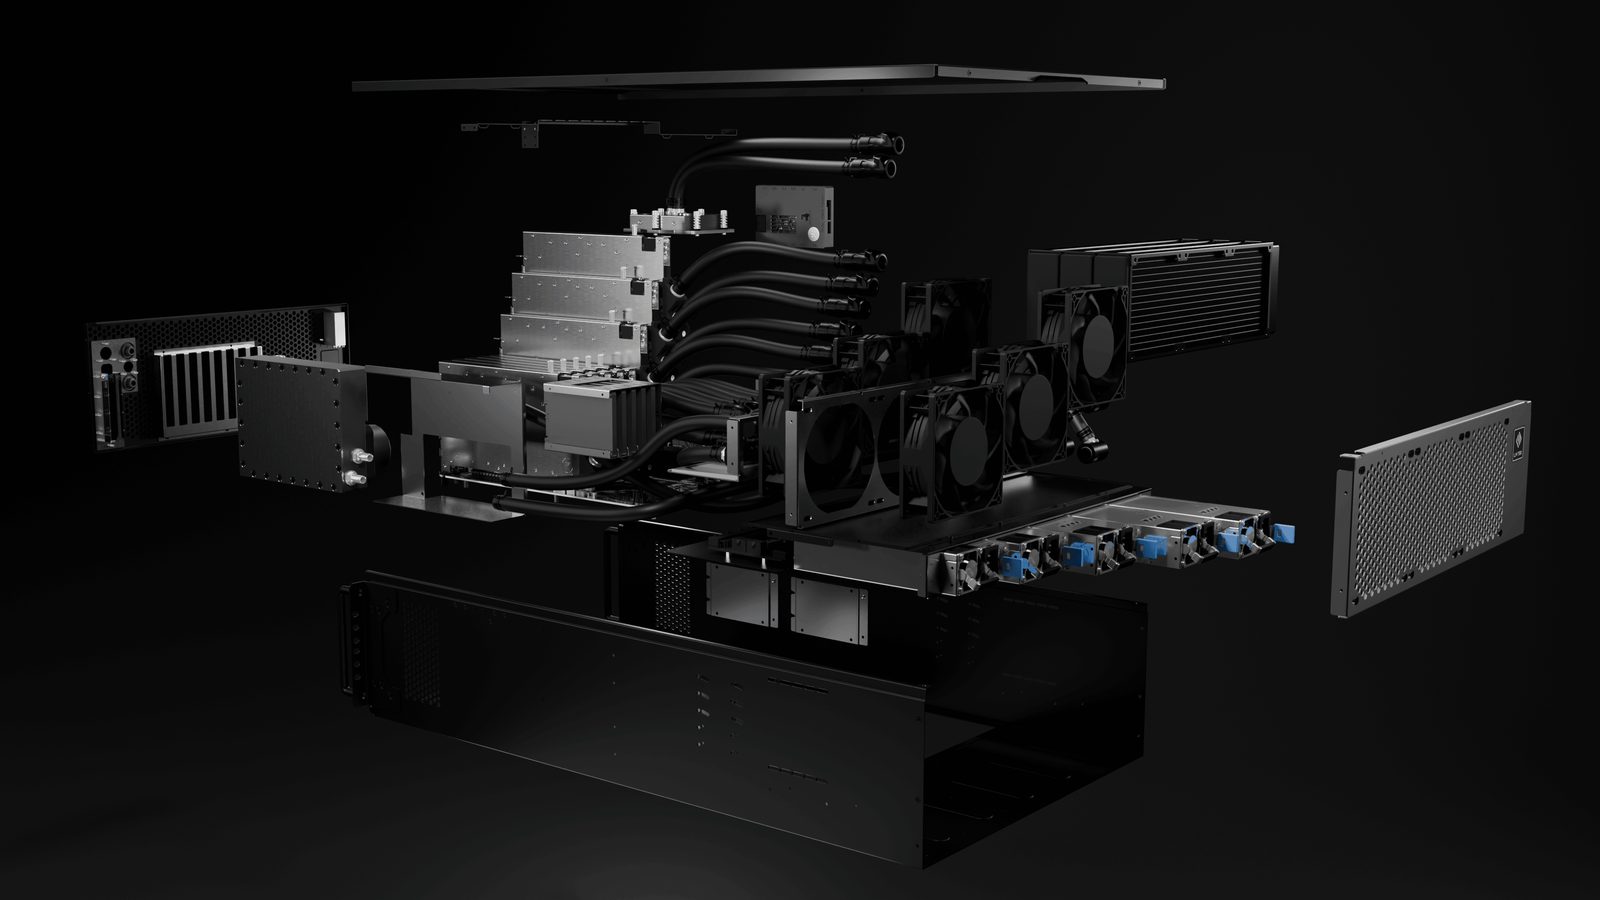
LM TEK 4U8GPU10KW
Barebone-платформа: восемь слотов GPU полной высоты в 4U, замкнутый контур жидкостного охлаждения с радиатором внутри шасси, пять блоков питания 2000 Вт 80 PLUS Titanium с резервированием. Плату, CPU, GPU и память подбираем под ваш сценарий инференса.
- Количество GPU
- до 8 (конфигурации от 2 до 8)
- Мощность на слот GPU
- До 700 Вт на слот, длительно
- Поддерживаемые сокеты CPU
- AMD SP5, Intel LGA 4677, Intel LGA 4710, Intel LGA 4710-2 (в зависимости от выбранной платы)
- Блоки питания
- 5 × 2000 Вт CRPS, 80 PLUS Titanium, с резервированием
Почему жидкостное охлаждение для инференса.
Нагрузка круглосуточная
Сервис инференса не останавливается ночью. В стресс-тестах LM TEK при 30 °C в помещении температура GPU держалась в диапазоне 76–81 °C — без троттлинга, который тихо съедает токены в секунду у воздушных систем.
Плотность там, где стоит стойка
Однослотовые водоблоки позволяют поставить восемь карт в 4U, где воздушный сервер того же класса занимает 6U или 8U. Это важно, когда серверная одна и место в ней ограничено.
Рост без переезда
На платформе LM TEK стартовая конфигурация на две карты и конечная на восемь — одно и то же шасси, тот же контур, та же силовая часть. Наращивание конкурентности не требует новой площадки.
Три пункта, и мы вернёмся с конфигурацией.
- 01 · Модель и сценарий
Что запускаете
Класс модели или конкретные веса, сценарий (чат, RAG, агенты, извлечение), число одновременных пользователей и требования к задержке.
- 02 · Данные и стек
Что вокруг модели
Объём корпуса документов для RAG, runtime инференса, требования к хранилищу и сети, планы по дообучению.
- 03 · Площадка
Где будет стоять
Стойка, доступная мощность, температура в серверной, страна поставки: Россия, Казахстан, Беларусь или Узбекистан.