
Сервер для обучения нейросетей с жидкостным охлаждением.
Дообучение открытых моделей на собственных данных, LoRA и QLoRA, обучение своих сетей для зрения и прогнозирования. Сервер для обучения нейросетей собираем от рабочей станции W9 ULTRA на четыре RTX PRO 6000 Blackwell до стоечных узлов RX MAX и Supermicro B300 на восемь ускорителей — и платформы LM TEK 4U8GPU10KW, которая держит восемь GPU до 700 Вт под полной нагрузкой часами в стандартной серверной, без внешнего CDU.
Обучение — это пиковая нагрузка на всё сразу и надолго.
Инференс нагружает GPU рывками, обучение — сплошным фронтом. Все ускорители работают на пределе часами и сутками, и в этот момент решают три вещи: память и её пропускная способность на карте, обмен между GPU внутри узла и стабильность питания и температуры. Любой троттлинг удлиняет эпоху, а сбой питания на десятом часу обнуляет её.
Честный масштаб: полное дообучение крупных моделей — задача многоузлового кластера с быстрым интерконнектом и общим хранилищем. Параметрически-эффективные методы (LoRA, QLoRA) на моделях среднего класса реалистичны на одном узле. Нагрузка пачечная: тяжёлая во время обучения, тихая между циклами, поэтому тот же сервер между запусками отдаётся под инференс и эксперименты.
Под это подбираем узел: двухпроцессорные платформы AMD EPYC или Intel Xeon с многоканальной ECC-памятью от 1 ТБ, восемь GPU в одном корпусе, NVMe U.2 под наборы данных и чекпойнты, сетевые адаптеры для объединения нескольких узлов.
От дообучения на одном узле до небольшого кластера.
| Уровень | Серия · пример конфигурации | Для чего |
|---|---|---|
| Дообучение и эксперименты | W9 ULTRA · 4 × RTX PRO 6000 Blackwell · Threadripper PRO 9995WX · 2 ТБ RDIMM ECC | LoRA/QLoRA на моделях среднего класса, обучение сетей компьютерного зрения, исследовательская группа без серверной |
| Production-дообучение | RX MAX · 8 × RTX PRO 6000 Blackwell · 2 × AMD EPYC 9555 · 1,5 ТБ ECC · 7U | Регулярные циклы дообучения, оценка на своих наборах, инференс обученной модели на том же узле |
| Крупные модели | Supermicro B300 · NVIDIA HGX B300 NVL8, 8 GPU · 2 × Xeon 6767P · 2 ТБ DDR5-6400 ECC · 8U | Полное дообучение и обучение больших моделей, узел кластера с общим хранилищем и планировщиком |
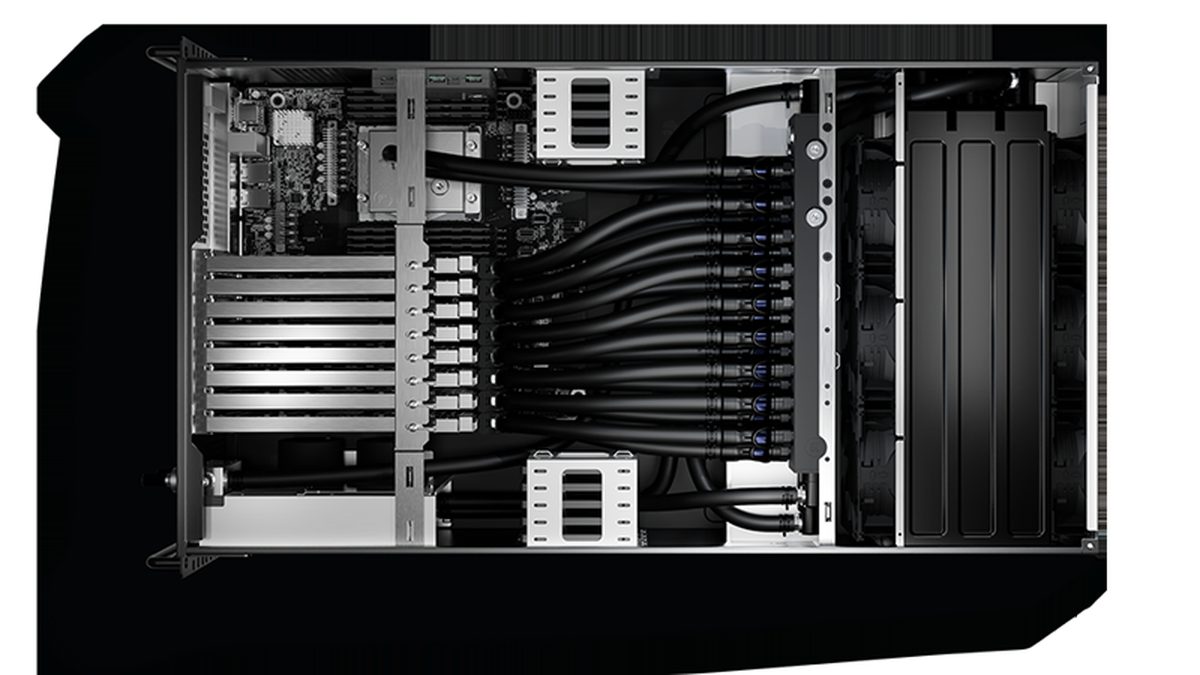
| Плотность с СЖО | LM TEK 4U8GPU10KW · 8 × H200 NVL с водоблоками · 2 × Xeon Platinum 8580 · 1 ТБ ECC · 4U | Длительные циклы на полной мощности в обычной серверной, без CDU |
Примеры, а не фиксированные спецификации; все позиции собираются под заказ. Итоговый BOM, включая сетевые адаптеры и хранилище для кластера, задаётся под внедрение. Оценка времени обучения для вашей модели и данных уточняется при запросе.
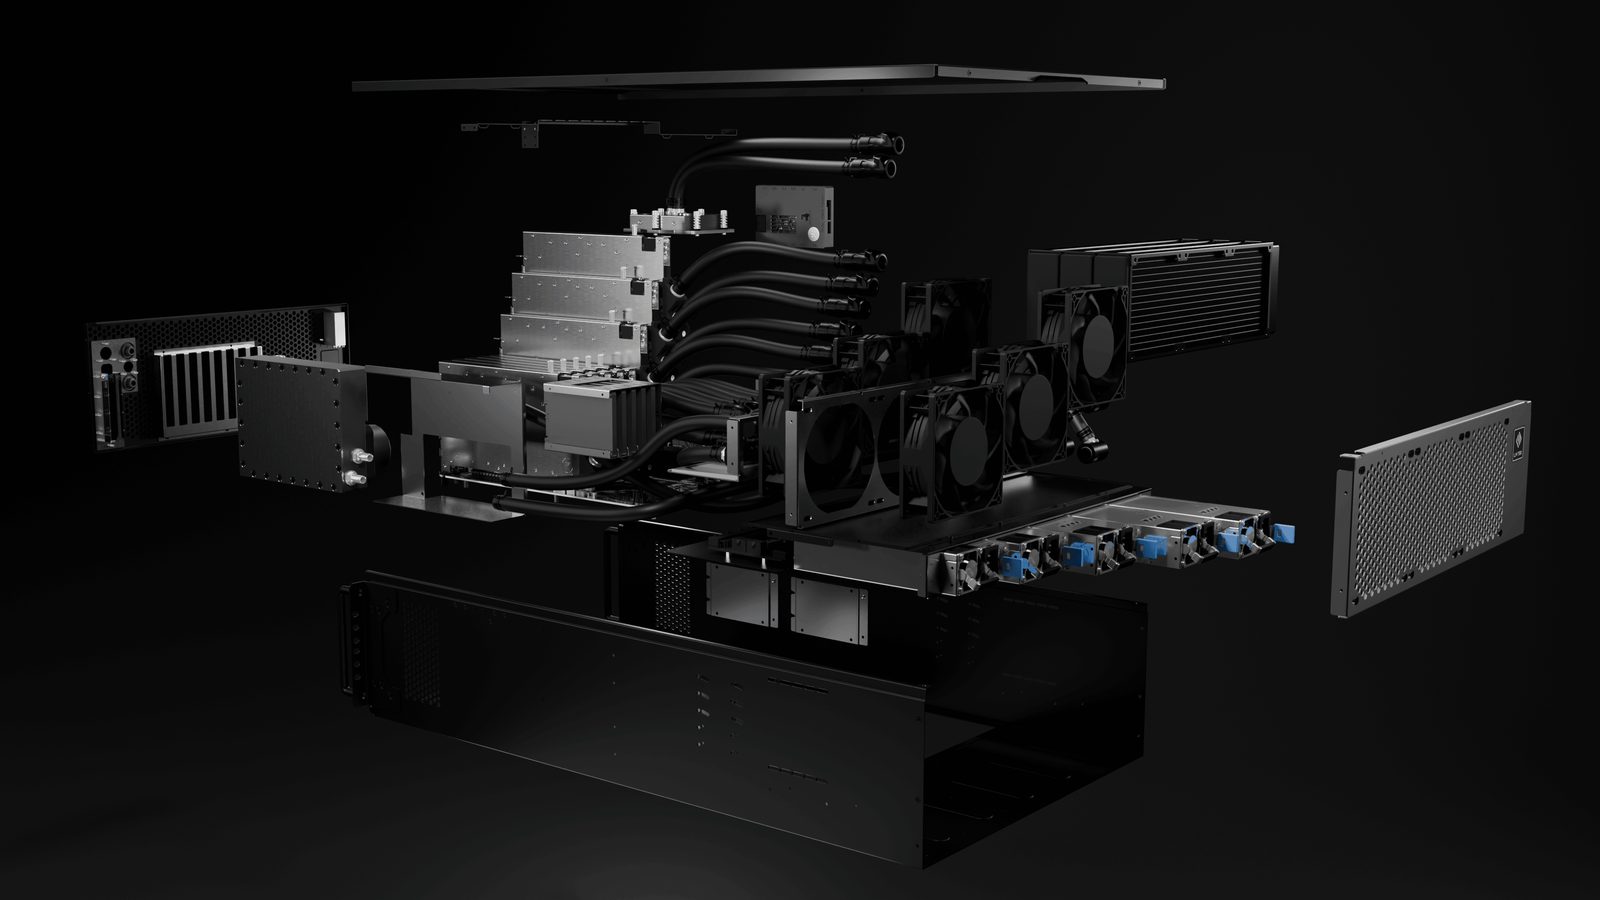
LM TEK 4U8GPU10KW
Шасси 4U, спроектированное вокруг замкнутого контура жидкостного охлаждения GPU и CPU, с силовой частью уровня платформы: пять блоков 2000 Вт 80 PLUS Titanium с резервированием и PDU, независимый от VRM материнской платы. Стартуйте с двух GPU, доводите до восьми.
- Количество GPU
- до 8 (конфигурации от 2 до 8)
- Мощность на слот GPU
- До 700 Вт на слот, длительно
- Поддерживаемые сокеты CPU
- AMD SP5, Intel LGA 4677, Intel LGA 4710, Intel LGA 4710-2 (в зависимости от выбранной платы)
- Блоки питания
- 5 × 2000 Вт CRPS, 80 PLUS Titanium, с резервированием
Почему жидкостное охлаждение для обучения.
Полная мощность без снижения частот
Обучение — единственная нагрузка, которая держит все восемь карт на максимуме одновременно. Водоблоки на каждой GPU и CPU снимают тепло напрямую, и в стресс-тесте при 30 °C карты остались в диапазоне 76–81 °C.
Питание, рассчитанное на 8 GPU
Бюджет мощности задан на уровне шасси: до 8000 Вт длительно с резервированием. Измеренное потребление полной конфигурации 6800–7000 Вт — эту цифру закладывайте в питание и охлаждение стойки.
Следующее поколение GPU
Шасси и контур, заложенные под жидкостное охлаждение на старте, дешевле, чем перестройка серверной на третьем этапе роста.
Три пункта для расчёта.
- 01 · Модель и метод
Что обучаете
Базовая модель или архитектура, метод (полное дообучение, LoRA, обучение с нуля), объём и тип данных, желаемая длительность цикла.
- 02 · Узлы и хранилище
Один узел или кластер
Число узлов, требования к сети между ними, объём набора данных и чекпойнтов, планы по инференсу обученной модели.
- 03 · Площадка
Питание и тепло
Доступная мощность на стойку, охлаждение помещения под 7 кВт тепла на узел, температура воздуха, страна поставки.