Распознавание транспортных и таможенных документов
OCR и языковые модели извлекают данные из ТТН, CMR, инвойсов и таможенных деклараций и сверяют их с заказами и заявками.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Каждая перевозка сопровождается пакетом документов: транспортная накладная, CMR, инвойс, упаковочный лист, сертификаты, декларация. Документы приходят сканами и фотографиями от водителей и контрагентов, а операторы вручную вбивают их в TMS и учётные системы. Ошибка в одной цифре — задержка на таможне или спор о взаиморасчётах.
Сверка документов между собой (совпадают ли вес, количество мест, номера контейнеров в инвойсе и накладной) выполняется выборочно и не успевает за потоком.
Международные перевозки добавляют документы на нескольких языках и разных форматах, что делает шаблонное распознавание бесполезным.
Что делает ИИ
PaddleOCRLayoutLM / DonutvLLMDoclingOpenCVPostgreSQL
Решение — конвейер обработки документов на локальных моделях, который принимает файлы из почты, мессенджеров и мобильного приложения водителя и возвращает структурированные данные.
- Классификация типа документа и языка, коррекция фото, разбиение пакетов.
- Распознавание печатного и рукописного текста, таблиц, печатей; извлечение полей языковой моделью без шаблонов под каждого контрагента.
- Кросс-проверка между документами одной перевозки и с заявкой в TMS; выявление расхождений до отправки в таможню или клиенту.
- Очередь ручной верификации только для сомнительных полей; дообучение на исправлениях операторов.
Конвейер закрывает документы «в один клик» и формирует архив с поиском по содержимому для разбора претензий.
Пилот охватывает 3–5 самых массовых типов документов и одного-двух крупных контрагентов; остальные форматы подключаются по мере накопления примеров.
Какие данные нужны
- Архив документов перевозок с проверенными данными
- Заявки и заказы из TMS
- Справочники контрагентов, кодов ТН ВЭД, маршрутов
Какая инфраструктура нужна
Профиль «компьютерное зрение и документы»: OCR и модели структуры документа работают на GPU с 24–48 ГБ памяти, языковая модель для извлечения полей на нескольких языках — на GPU с 48–96 ГБ. Для экспедитора с тысячами документов в день достаточно рабочей станции W9 MAX из рабочие станции с двумя GPU и NVMe под очередь и архив.
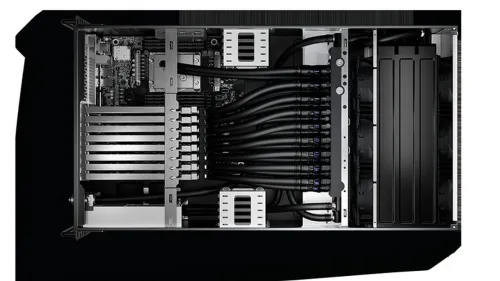
Для крупного оператора с филиалами и требованием к отказоустойчивости — сервер R5 PLUS или RX PRO из раздела GPU-серверы. Коммерческие условия перевозок и данные контрагентов не покидают контур компании.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Логистика и транспорт»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.