
Оцифровка архивов и интеллектуальный документооборот ведомства
OCR и LLM превращают бумажные архивы и входящие документы в структурированные данные с поиском, извлечением реквизитов и проверкой.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Архивы ведомств, судов, МФЦ, кадастровых и регистрационных палат — миллионы дел на бумаге и в сканах без распознанного текста. Найти документ, проверить историю объекта или выдать справку означает ручной поиск по описям. Входящий поток — письма, договоры, акты, заявления — регистрируется вручную, реквизиты перепечатываются, а ошибки в них тянутся дальше по системам.
Классический OCR спотыкается на рукописных записях, печатях, старых машинописных документах и разнородных бланках. Извлечь из документа не просто текст, а структуру — стороны, даты, суммы, номера объектов — и проверить её на соответствие реестрам требует более сложных моделей, которые при этом обязаны работать в контуре ведомства.
Что делает ИИ
PaddleOCRTrOCRvLLMQwenElasticsearchPostgreSQL
Сканы проходят предобработку и нейросетевое распознавание печатного и рукописного текста, затем локальная LLM извлекает реквизиты по схеме типа документа, классифицирует его и сверяет с реестрами. Результат попадает в СЭД или архивную систему с полнотекстовым и семантическим поиском; сомнительные фрагменты подсвечиваются оператору.
- Распознавание рукописных и машинописных документов с дообучением на образцах архива.
- Автоматическая регистрация входящих с извлечением реквизитов и определением адресата.
- Поиск по архиву на естественном языке и по смыслу, а не только по номеру дела.
- Проверка комплектности и противоречий в пакетах документов.
- Обезличивание персональных данных при выдаче копий.
Какие данные нужны
- Сканы архивных дел и описи
- Входящий документопоток из СЭД
- Реестры и справочники для сверки
Какая инфраструктура нужна
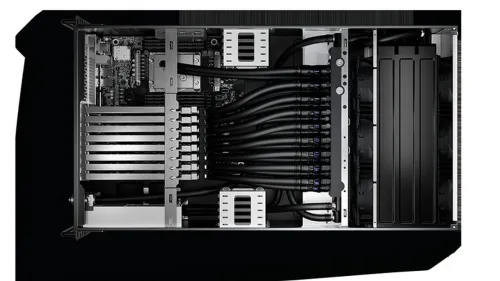
Профиль data: конвейер из OCR-моделей, LLM среднего размера и индексации миллионов страниц — нагрузка распределяется между GPU, многоядерным CPU для обработки изображений и быстрым хранилищем. Ведомству с архивом в единицы миллионов страниц подходит сервер R7 PRO с двумя GPU из раздела GPU-серверов; для запуска на одном отделе — станция W7 ULTRA из рабочих станций. Промышленные сканеры подключаются напрямую в сеть узла, распознанные документы и индексы хранятся на локальном массиве с расширением по мере оцифровки. Скорость оцифровки ограничивается сканированием, а не распознаванием: один GPU обрабатывает тысячи страниц в час.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Государство и «умный город»»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.