LLM-ассистент по комплаенсу и регуляторным требованиям
Языковая модель в контуре банка отвечает по нормативным актам и внутренним политикам, проверяет документы и готовит отчётность.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Объём регуляторных требований к финансовым организациям растёт: положения и указания регулятора, законы, внутренние политики, письма и разъяснения. Комплаенс-специалисты тратят часы на поиск применимой нормы и сверку новой редакции с предыдущей, а бизнес-подразделения ждут ответа днями.
Проверка договоров, маркетинговых материалов и новых продуктов на соответствие требованиям выполняется вручную и зависит от загрузки конкретного юриста. Ошибка стоит предписаний и штрафов.
Использовать внешние LLM-сервисы для таких задач невозможно: во внутренних документах содержится банковская тайна и сведения о клиентах.
Что делает ИИ
vLLMQwen / LlamaLangChainQdrantDoclingPostgreSQL
Решение — ассистент на открытой языковой модели, развёрнутой на сервере организации, с базой нормативных документов и внутренних политик.
- RAG по корпусу: нормативные акты с историей редакций, внутренние политики, регламенты, ответы на запросы регулятора; каждый ответ со ссылкой на пункт.
- Сравнение редакций документов и выделение изменений, влияющих на процессы.
- Проверка договоров и материалов по чек-листам: поиск отсутствующих обязательных условий, рискованных формулировок.
- Помощь в подготовке отчётов и ответов на запросы регулятора по шаблонам организации.
Ответы ассистента носят вспомогательный характер: финальное решение принимает специалист, а система ведёт журнал запросов и источников для аудита. Корпус обновляется автоматически при выходе новых редакций, а качество ответов проверяется на контрольном наборе вопросов комплаенса.
Какие данные нужны
- Нормативные акты и их редакции
- Внутренние политики, регламенты, договоры
- История запросов и ответов комплаенса
Какая инфраструктура нужна
Профиль «инференс LLM»: для юридических текстов важны качество модели и длинный контекст, поэтому используются модели на 30–70 млрд параметров с контекстом в десятки тысяч токенов. Это требует GPU с 80 ГБ и более памяти: сервер R7 ULTRA с H200 NVL или RX ULTRA из раздела GPU-серверы.
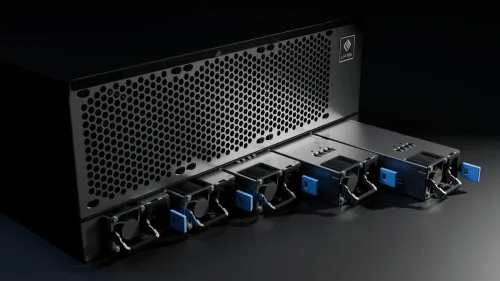
Для организации с сотнями пользователей и несколькими моделями (юридическая, для отчётности, для проверки документов) разумна платформа LM TEK 4U8GPU10KW на 8 GPU в обычной серверной. Векторная база и архив документов размещаются на NVMe того же узла; данные не покидают периметр.


Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Финансы и страхование»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.