
Предиктивное обслуживание промышленного оборудования
Модели на телеметрии станков и агрегатов предупреждают об отказе за дни до остановки и переводят ремонт с графика на состояние.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Плановое обслуживание по регламенту меняет исправные узлы и одновременно не спасает от внезапных отказов. Час простоя автоматической линии стоит дорого, а аварийный ремонт с ожиданием запчастей растягивается на дни.
Телеметрия с приводов, подшипников, компрессоров и насосов уже собирается в SCADA, но её никто не анализирует: инженеры смотрят на тренды постфактум, когда оборудование уже вышло из строя.
Дополнительная сложность — разнородность парка: станки разных поколений, датчики с разной частотой опроса, часть оборудования без телеметрии вовсе. Готовые «коробочные» продукты вендоров оборудования охватывают только свои агрегаты и не дают единой картины по цеху.
Что делает ИИ
PythonXGBoostPyTorchClickHouseApache KafkaGrafana
Мы собираем историю датчиков (вибрация, ток, температура, давление) вместе с журналом ремонтов и обучаем модели, которые отличают нормальное поведение узла от предотказного.
- Обнаружение аномалий на потоках телеметрии без разметки: модель учится на «здоровом» режиме и сигналит об отклонении.
- Прогноз остаточного ресурса (RUL) по историческим отказам для узлов с достаточной статистикой.
- Ранжирование оповещений по критичности, чтобы служба главного механика получала не сотни алертов, а список приоритетов.
- Интеграция с ТОиР-системой: автоматическое создание заявок на ремонт.
Для оборудования без штатной телеметрии мы предлагаем недорогие накладные датчики вибрации и тока с беспроводной передачей. Пилот на 10–20 критичных агрегатах занимает около трёх месяцев, после чего модели тиражируются на остальной парк с минимальной донастройкой.
Какие данные нужны
- Телеметрия SCADA за 1–3 года
- Журнал ремонтов и отказов
- Паспорта оборудования и регламенты ТО
Какая инфраструктура нужна
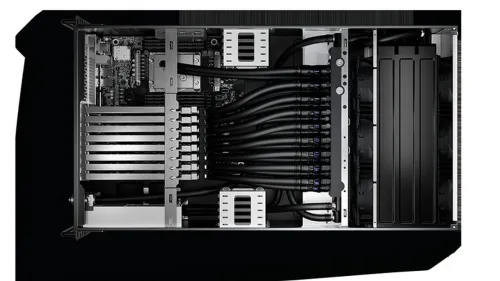
Это профиль «данные»: основная нагрузка — обработка временных рядов с тысяч датчиков, градиентный бустинг и относительно небольшие нейросети. Ядра CPU и объём оперативной памяти важнее, чем количество GPU. Для завода с несколькими тысячами тегов подходит сервер R7 PRO из раздела GPU-серверы с 1–2 GPU для обучения нейросетевых детекторов и быстрым NVMe-массивом под колоночную базу.
Для пилота на одном участке достаточно рабочей станции W7 ULTRA из рабочих станций. Инференс лёгкий и может работать рядом со SCADA; вычисления остаются на площадке, данные не уходят в облако.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Промышленность и производство»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.