
Генерация контента для медиа: тексты, изображения, озвучка
Собственный узел генеративного ИИ для редакции: черновики текстов, иллюстрации, обложки и синтез голоса без ограничений облачных сервисов.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Редакции, продакшены и маркетинговые службы медиахолдингов производят сотни единиц контента в день: новости, анонсы, обложки, тизеры, озвучка роликов, адаптация под площадки. Генеративные модели закрывают заметную часть рутины, но облачные сервисы диктуют свои условия: лимиты, тарификация за каждый запрос, невозможность дообучить модель под стиль издания и вопросы с правами на результат.
Кроме того, черновики и неопубликованные материалы утекают во внешний сервис ещё до выхода — для новостных и развлекательных брендов это прямой репутационный и коммерческий риск.
Что делает ИИ
vLLMStable Diffusion/FLUXComfyUICoqui/XTTSLoRAFastAPI
На собственном GPU-узле разворачиваются открытые модели: LLM для текстов, диффузионные модели для изображений, TTS для озвучки. Модели дообучаются на архиве издания — стилистика заголовков, визуальный язык обложек, голоса дикторов с их согласия — и подключаются к редакционной CMS через API.
- Черновики новостей и анонсов по пресс-релизам и стенограммам, рерайт под разные площадки.
- Генерация иллюстраций и обложек в фирменном стиле с помощью LoRA-адаптеров.
- Синтез речи для подкастов, аудиоверсий статей и дубляжа промороликов.
- Ролевой доступ, водяные знаки и журнал генераций для контроля.
Какие данные нужны
- Архив публикаций и визуальных материалов
- Стайлгайд и редакционные правила
- Записи голосов дикторов с согласия
Какая инфраструктура нужна
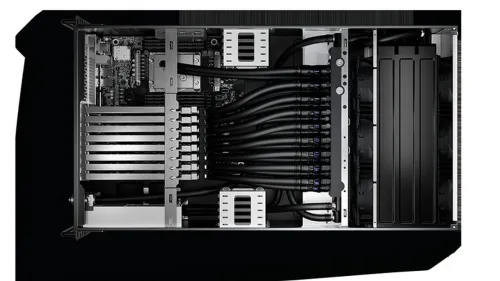
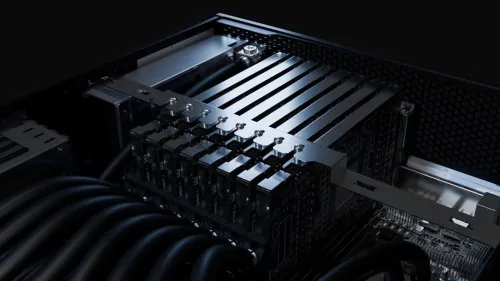
Профиль render: генерация изображений и видео нагружает GPU с большим объёмом памяти и высокой производительностью в FP16/FP8, а LLM и TTS работают рядом на тех же ускорителях. Для редакции из 20–50 авторов подходит станция W7 MAX или W9 MAX из раздела рабочие станции с двумя-четырьмя GPU класса RTX PRO 6000; медиахолдингу с несколькими редакциями — сервер RX MAX из GPU-серверов. Хранилище NVMe нужно под веса моделей и библиотеку сгенерированных материалов; при росте числа пользователей узел масштабируется до платформы LM TEK 4U8GPU10KW. Станции ставятся прямо в редакции: жидкостное охлаждение держит шум и температуру в пределах офисного помещения даже при постоянной загрузке нескольких GPU. Веса моделей, адаптеры и результаты не покидают сеть организации.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Телеком и медиа»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.