Дистанционный мониторинг пациентов и раннее предупреждение ухудшений
Потоки с носимых датчиков и мониторов у койки анализируются моделями раннего предупреждения — сервер под тысячи пациентов.
Диапазоны по отраслевым публикациям и типовым внедрениям; результат зависит от данных и процессов заказчика.
Что решаем
Хронические пациенты после выписки и больные в общих палатах наблюдаются эпизодически: измерения раз в несколько часов, осмотр раз в сутки. Ухудшение — сепсис, декомпенсация сердечной недостаточности, гипогликемия — часто развивается между контрольными точками. По отраслевым публикациям до 40 % экстренных госпитализаций хроников можно было предсказать за 24–48 часов по данным носимых устройств.
Телемедицинские платформы собирают сигналы с глюкометров, тонометров, пульсоксиметров и прикроватных мониторов, но превращаются в поток сырых чисел, на который персонал не успевает реагировать. Нужен слой аналитики, который отделяет реальную тревогу от шума и делает это с тысячами пациентов одновременно.
Что делает ИИ
Apache KafkaTimescaleDBPyTorchscikit-learnFHIR
Данные устройств поступают в потоковую шину, где модели временных рядов и детекторы аномалий оценивают динамику каждого пациента с учётом его базовой линии. Оценка риска пересчитывается при каждом измерении; при превышении порога формируется задача для медсестры с обоснованием.
- Индивидуальные пороги вместо общих: модель учится на истории конкретного пациента.
- Скоринг ухудшения (аналог NEWS2 с ML-надстройкой) и прогноз на 12–48 часов.
- Снижение ложных тревог за счёт объединения нескольких сигналов.
- Интеграция с МИС и мобильным приложением персонала.
Важно: MIARCH поставляет вычислительную инфраструктуру и помогает развернуть модели. Само ПО для постановки диагноза является медицинским изделием и проходит регистрацию отдельно — на стороне разработчика или клиники.
Какие данные нужны
- Телеметрия носимых устройств и мониторов
- Электронные медкарты и назначения
- История госпитализаций и исходов
Какая инфраструктура нужна
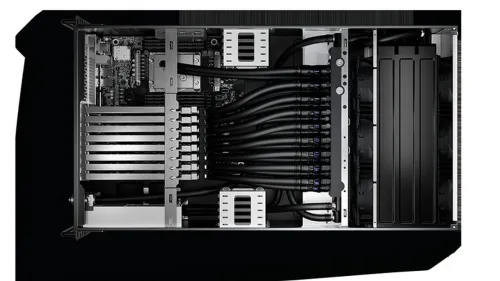
Профиль data: нагрузка — это десятки тысяч потоков коротких временных рядов, потоковая обработка и регулярное переобучение табличных моделей. Ключевые ресурсы — ядра CPU, оперативная память под in-memory аналитику и быстрые NVMe для базы временных рядов; GPU нужен один-два для обучения и инференса нейросетевых моделей ЭКГ. Сервер R7 PRO из раздела GPU-серверов закрывает потребности сети клиник на 5–20 тысяч наблюдаемых пациентов; пилот на одном отделении стартует со станции W7 ULTRA из рабочих станций. Резервирование питания и дисков обязательно: система работает круглосуточно.

Как идёт проект
- 01
Данные и цель
Фиксируем метрику успеха, источники данных и ограничения: on-premise, персональные данные, сроки.
- 02
Пилот на нашей конфигурации
Стартовая машина под задачу и подтверждённый профиль нагрузки перед закупкой кластера.
- 03
Инфраструктура
Поставка серверов, станций и охлаждения, монтаж, ввод в эксплуатацию, ПО и мониторинг.
- 04
Сопровождение
Масштабирование, обновление ускорителей в том же шасси, сервис и запчасти.
Что ещё автоматизируют в отрасли «Здравоохранение и фарма»
Опишите задачу и данные.
Вернёмся с профилем нагрузки, конфигурацией и коммерческим предложением на поставку в вашу страну.