Как выбрать GPU-сервер под инференс и обучение — вопрос, на который нельзя ответить моделью ускорителя. Самая дорогая ошибка на старте — купить машину под одну задачу и через полгода обнаружить, что реальная нагрузка выглядит иначе: чат-ассистент оказался RAG-системой, а «немного дообучить модель» превратилось в регулярный цикл fine-tuning. Этот чек-лист из 12 пунктов мы используем на первой встрече с заказчиком. Пройдите по нему до запроса коммерческого предложения — и разговор с интегратором станет короче, а конфигурация точнее.
Часть 1. Нагрузка
1. Определите доминирующий паттерн нагрузки
Большинство корпоративных внедрений ИИ укладываются в пять шаблонов, и у каждого свой узкий канал:
| Паттерн | Что ограничивает | Типовой масштаб |
|---|---|---|
| RAG (ответы по своим документам) | Хранилище, embedding-модель, векторная БД | Один сервер → малый кластер |
| Чат / ассистенты | Токены в секунду на пользователя, число одновременных сессий | Рабочая станция → один сервер |
| Агентные сценарии | Пропускная способность и надёжность, журналирование состояния | Один сервер → кластер |
| Fine-tuning | Пропускная способность памяти, межузловое соединение | Многоузловой кластер (LoRA — один сервер) |
| Классификация / извлечение | Пропускная способность, предсказуемая стоимость | Рабочая станция → один сервер |
Реальные проекты — это смесь: 80 % чата плюс 20 % RAG считается как чат с дополнительным хранилищем и конвейером эмбеддингов. Назовите главный паттерн, остальные — надстройка.
2. Инференс или обучение — разные машины
Инференс требует памяти под веса модели и контекст, плюс достаточную пропускную способность, чтобы обслужить N пользователей одновременно. Хорошо подобранная модель класса 8B на одной карте нередко обслуживает больше пользователей, чем модель 70B, которая под нагрузкой уходит в тайм-аут. Обучение и полноценный fine-tuning — это пиковая нагрузка на память и межкарточный обмен, часто на несколько узлов, с простоем между циклами. Если основная задача — инференс, не покупайте кластер «на случай обучения»: LoRA-класс техник на одном сервере закрывает большинство корпоративных сценариев адаптации.
3. Посчитайте память GPU, а не только «мощность»
Веса модели должны поместиться в память ускорителей с запасом на контекст и батч. Квантованная модель 8B–30B умещается на одной-двух профессиональных картах; модели старших классов требуют суммарной памяти нескольких карт и быстрого соединения между ними (NVLink там, где он поддерживается). Сначала определите класс модели и число одновременных пользователей, потом — число и тип GPU.
4. Проверьте, где живут данные
Если модель работает с персональными данными, коммерческой тайной, финансовой отчётностью, медицинскими записями или данными под NDA, облачный API отпадает по юридическим причинам ещё до технических. Тогда сервер нужен внутри периметра, а вопрос «покупать ли железо» смещается на стадию пилота. Подробнее — в статье о суверенном корпоративном ИИ.
Часть 2. Платформа
5. Выберите стадию, а не финальную конфигурацию
Разумная траектория закупки — поэтапная. Стадия 1: стартовый узел на 1–2 GPU, один сценарий, ограниченный круг пользователей. Стадия 2: производственный сервер в стойке на 2–8 GPU с резервированием питания, мониторингом и резервным копированием. Стадия 3: кластер из 2–8 узлов. Стадия 4: выделенная AI-инфраструктура. Референсные конфигурации, к которым мы отталкиваемся: 2 × RTX 6000 Ada с 256 ГБ ОЗУ на старте; 4 × RTX A6000 и 512 ГБ для среднего уровня; 8 × NVIDIA H200 NVL и 1 ТБ для производственного максимума. Это ориентиры из реальных проектов, а не фиксированные комплекты.
6. Купите шасси и охлаждение под следующее поколение GPU
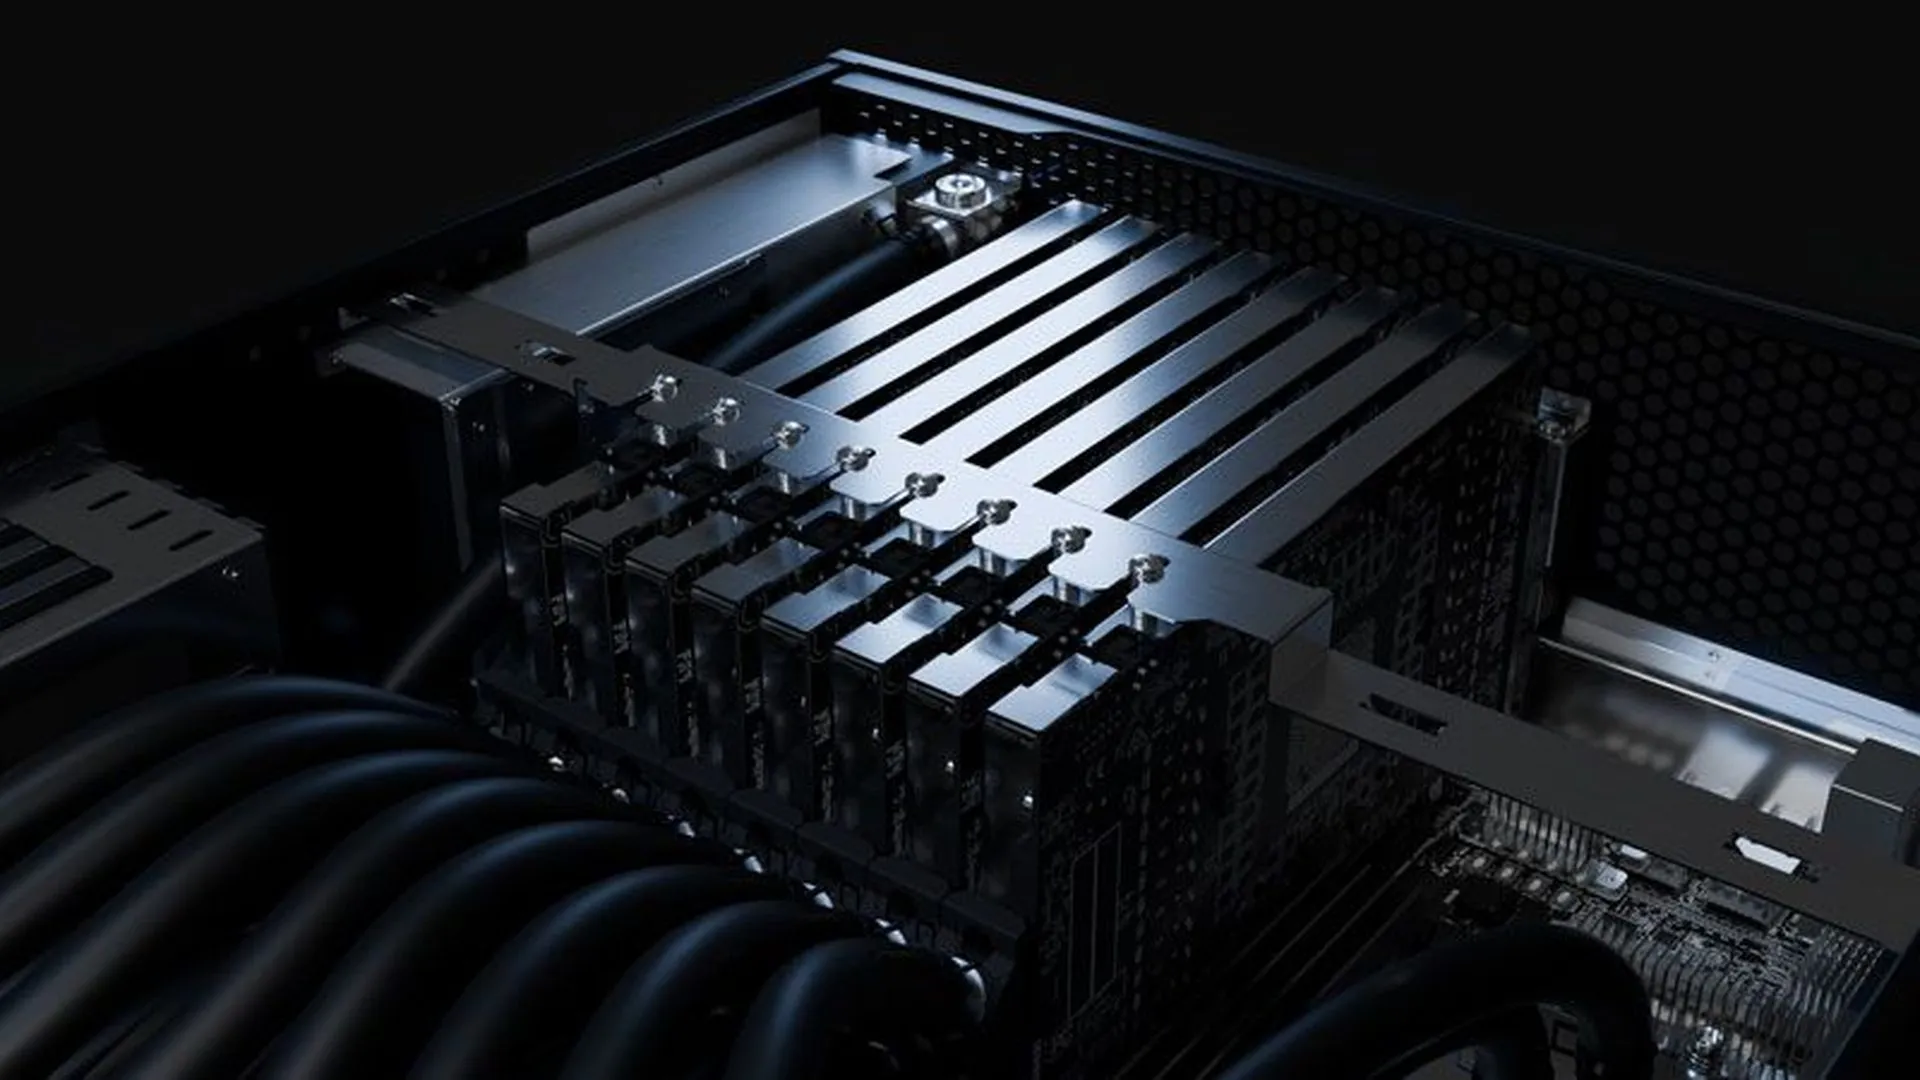
Сегодняшние 700 Вт на карту — завтрашние 1000 Вт и выше. Воздушное охлаждение на высокой плотности исчерпывает запас быстрее, чем устаревает купленный ускоритель. Платформа с жидкостным охлаждением, купленная на стадии 1–2, дешевле, чем перестройка на стадии 3. Идеальный вариант — шасси, в котором старт с двух GPU и финал с восемью — это один и тот же актив: платформа LM TEK 4U8GPU10KW, например, несёт конфигурацию от 2 × RTX 6000 Ada до 8 × H200 NVL в одном корпусе 4U, апгрейд — карта, водоблок и проверка по спецификации. Развилку «воздух или жидкость» мы разобрали отдельно.
7. Избегайте привязки к проприетарной плате
Сервер на кастомной материнской плате решает вопросы компоновки, но закрывает платформу: каждая замена, апгрейд и запчасть идут через одного поставщика. Для корпоративного заказчика, а тем более при поставках в Россию и СНГ, это неприемлемый риск. Предпочтительны платформы на стандартных платах EATX / EEB с серийными процессорами (AMD SP5, Intel LGA 4677 / LGA 4710), памятью DDR5 RDIMM, NVMe и сетевыми картами — по нескольку поставщиков на каждую позицию, а у каждой детали второй источник.
8. Проверьте питание — от розетки до слота
Восемь карт по 700 Вт плюс два процессора — это 7 кВт длительно. Проверьте три уровня: мощность и резервирование блоков питания (в референсной платформе — 5 × 2000 Вт 80 PLUS Titanium с резервированием, до 8000 Вт), распределение питания на GPU независимо от VRM материнской платы и, наконец, ввод в стойку и ИБП. Класс эффективности блоков питания при многокиловаттной нагрузке — реальные операционные расходы и всё чаще критерий тендера.
Часть 3. Площадка и эксплуатация
9. Измерьте серверную, прежде чем выбирать плотность
Самое жёсткое ограничение при масштабировании ИИ — обычно помещение, а не кремний. Запишите три числа: доступная мощность на стойку, холодопроизводительность кондиционера и температура воздуха на входе в стойку летом. Классическая серверная рассчитана на 2–3 кВт на стойку; один 8-GPU сервер даёт 7 кВт тепла. Платформа с замкнутым контуром рассчитана на 5–30 °C в помещении и не требует подвода жидкости от здания, но кондиционер под 7 кВт нужен в любом случае. Что такое CDU и когда он всё-таки понадобится — читайте здесь.
10. Заложите хранилище и сеть под паттерн
RAG упирается в скорость чтения корпуса документов; обучение — в межузловую сеть и общее хранилище. Для одного сервера обычно достаточно 2–8 NVMe-накопителей в корзине шасси и сетевой карты в формате OCP 3.0 или PCIe. Для кластера с самого начала планируйте высокоскоростное соединение между узлами и планировщик задач: переезд на них потом обходится дорого.
11. Определите, как будут обслуживать сервер
Спросите: как заменить одну карту, не останавливая остальные семь? У сервера с жидкостным охлаждением ответ должен звучать так: отсоединить быстроразъёмные муфты (QDC) на водоблоке и извлечь карту без слива контура. Уточните, входят ли QDC в комплект, кто поставляет водоблоки для новых карт и есть ли запчасти контура на открытом рынке. Заводская заправка хладагентом и опрессовка — обязательные пункты приёмки.
12. Договоритесь о стеке ПО до покупки
Среда выполнения, контейнерная схема, мониторинг и система наблюдаемости, выбранные на стадии 1, должны работать и на стадии 4. Переносить неудачно выбранный runtime через три переезда в стойку — дорого. Стартовый узел после запуска производственного сервера становится средой разработки и оценки моделей, а не выбрасывается — планируйте это заранее.
Как использовать чек-лист
Пункты 1–4 определяют, что вы покупаете; 5–8 — на какой платформе; 9–12 — впишется ли она в вашу площадку и процессы. Если после прохождения списка остаются пробелы в пунктах 9 и 11, не переходите к выбору GPU: сначала закройте вопросы помещения и обслуживания. Именно они чаще всего превращают удачную техническую конфигурацию в проблемную эксплуатацию.
Что дальше
- GPU-серверы — конфигурации на 2–8 ускорителей под инференс и обучение.
- AI-серверы с жидкостным охлаждением — платформа 4U на 8 GPU до 700 Вт для обычной серверной.
- Рабочие станции — стартовый узел на 1–4 GPU для пилота и разработки.
- Решения — поэтапная траектория от пилота до выделенной инфраструктуры.
Пришлите ответы на 12 пунктов в свободной форме — подготовим конфигурацию и проверим её против параметров вашей серверной. Поставка в Россию, Казахстан, Беларусь и Узбекистан.
Обсудить задачу с инженером